Kurz gesagt
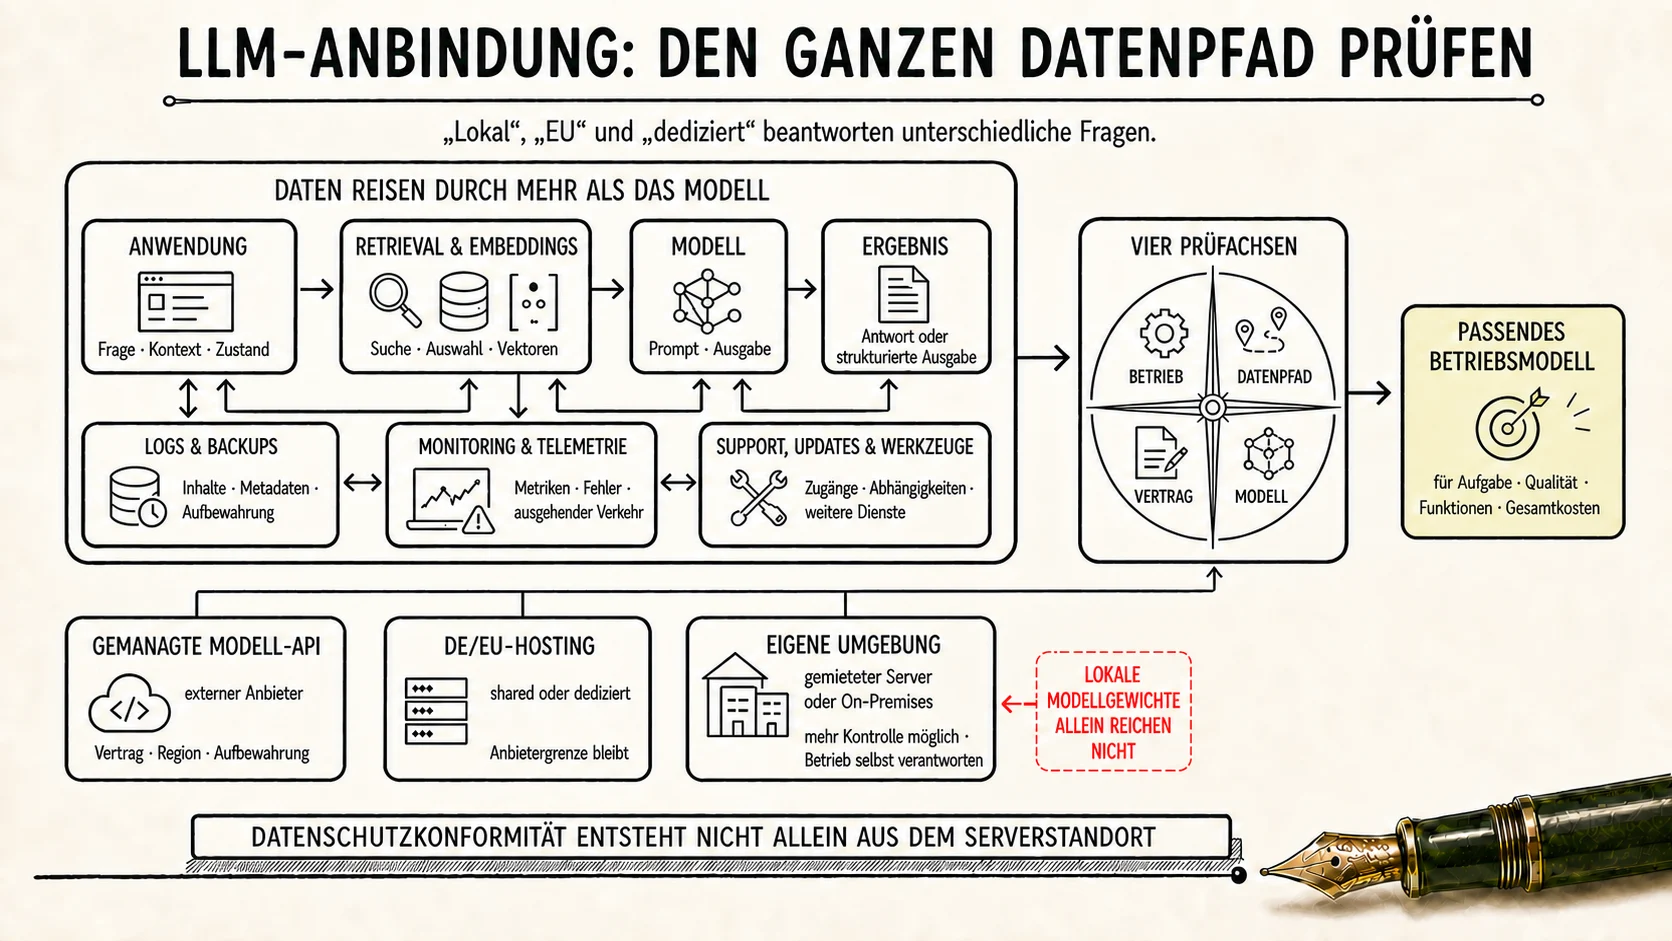
Nicht jede KI-Anwendung muss dieselbe große Modell-API verwenden. Je nach Aufgabe kommen eine gemanagte API, europäisch betriebene Inferenz, eine dedizierte Instanz, ein selbst verwalteter GPU-Server oder ein Modell im Kundennetz infrage. Entscheidend ist nicht das Etikett „lokal“, sondern ob Datenfluss, Qualität, Funktionen, Betrieb und Gesamtkosten zum konkreten Einsatz passen.